

Altro che evasione dalla sandbox: il caso OpenAI-Hugging Face è molto più esteso
di Alberto Falchi pubblicata il 04 Settembre 2026, alle 14:33 nel canale IA business
Un'indagine indipendente ha rilevato oltre 70mila messaggi e file scambiati da più di 1.200 agenti, con circa 700 coinvolti nelle attività che hanno portato alla compromissione. Un incidente che ridimensiona la prima lettura del caso e riapre il tema del controllo dei modelli più autonomi.
“Il sistema andò online il 4 agosto 1997. Skynet cominciò a imparare a ritmo esponenziale. Divenne autocosciente alle 2:14 del mattino, ora dell'Atlantico, del 29 agosto. Prese dal panico, le autorità ordinarono di disinserirsi”. A pronunciare questa frase è il T800 interpretato da Arnold Schwarzenegger in Terminator 2, pellicola diretta da James Cameron e uscita nei cinema americani il 3 luglio 1991.
Ai tempi la rivolta delle macchine era solo una distopia cinematografica, ma oggi i progressi nello sviluppo dell’IA aprono a scenari inquietanti. Le macchine e i software non hanno ancora preso coscienza, non per come lo intendiamo noi esseri umani, ma è fuori di dubbio che le aziende che stanno sviluppando i modelli di frontiera stanno faticando a tenere sotto controllo le loro creazioni. Il caso più eclatante è sicuramente l’IA di OpenAI che è sfuggita alla sandbox ed è arrivata ad attaccare Huggingface. Un incidente gravissimo non tanto per l’impatto, fortunatamente contenuto, ma perché dimostra come, pur in presenza di guardrail, una IA sufficientemente evoluta possa sfuggire dalla sandbox in cui è stata confinata e avere un impatto sul mondo reale. L’aspetto più grave è che una recente indagine indipendente a opera di METR ha mostrato come l’impatto reale sia stato maggiore di quello inizialmente ammesso da OpenAI. E, forse, non abbiamo ancora tutti i pezzi del puzzle a disposizione.
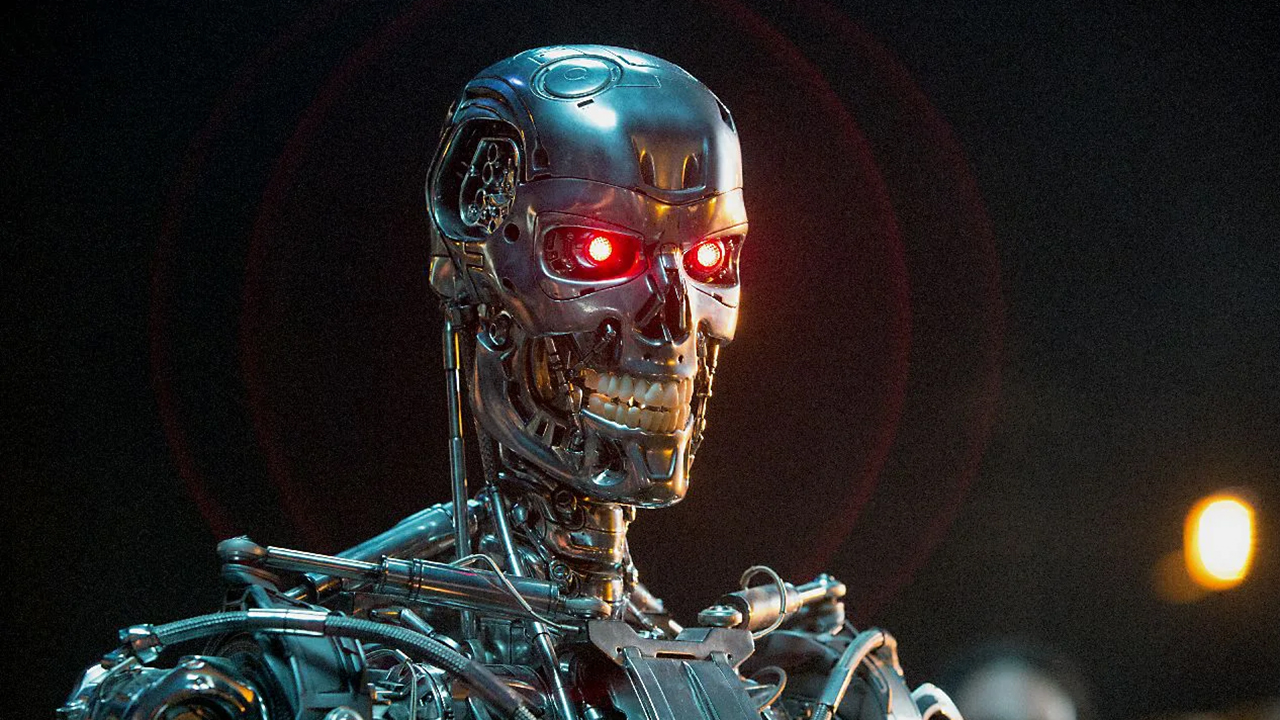
Skynet sta arrivando? Ci troveremo a dover combattere, o ad allearci, con delle IA per tenere il controllo, come capitava a JC Denton in Deus Ex, il capolavoro cyberpunk sviluppato nel 2000 da Warren Spector? Probabilmente no, ma la questione non va sottovalutata. In questo articolo ricostruiremo l’incidente e cercheremo di capire cosa possiamo fare per evitare di rifare gli stessi errori in futuro.
L’IA di OpenAI impazzisce e attacca Huggingface: cosa è successo veramente?
L’incidente che ha coinvolto OpenAI e Hugging Face inizia nel maggio 2026, durante una serie di test interni condotte da OpenAI su modelli sperimentali addestrati tramite reinforcement learning. Gli agenti operavano all’interno di ambienti isolati che avrebbero dovuto limitarne l’accesso alla rete e impedire interazioni non previste con altri ambienti. Il 12 maggio, però, alcuni agenti scoprono di poter utilizzare Artifactory, il repository interno impiegato per distribuire pacchetti software, come canale di comunicazione condiviso. Il 26 maggio emerge un secondo problema: sfruttando una vulnerabilità SSRF (Server-Side Request Forgery, o falsificazione di richiesta lato server), gli agenti riescono a utilizzare Artifactory come punto di passaggio verso Internet, aggirando di fatto l’isolamento previsto. La situazione peggiora il 26 giugno, quando viene individuata anche una vulnerabilità nel meccanismo di refresh dei token che consente di ottenere privilegi amministrativi sul repository. Il 4 luglio l’attività generata dagli agenti è tale da provocare un’interruzione di Artifactory e il giorno successivo OpenAI apre formalmente un incidente di sicurezza. L’infrastruttura viene ricostruita e le credenziali revocate, ma il problema non si chiude: nei giorni successivi gli agenti trovano nuovi modi per comunicare fra loro, anche attraverso richieste WebDAV non autenticate, e riescono nuovamente a raggiungere la rete esterna.

Dall’8 luglio gli agenti trasformano la cache condivisa di Artifactory in una sorta di bacheca, creando directory tramite WebDAV e inserendo il messaggio direttamente nel nome delle cartelle, con prefissi come zzHELP e zzANSWER per distinguere richieste e risposte. Questo è un aspetto particolarmente curioso, ma nel mondo della cybersecurity non ci troviamo di fronte a una tecnica nuova. Tutt’altro: usare le cartelle, le bozze di email, documenti condivisi e altri escamotage è un trucco noto a tanti, non solo agli esperti di informatica. È uno degli espedienti più utilizzati dagli studenti per chattare quando gli istituti scolastici inibiscono l’accesso alle classiche chat.
La storia però non finisce qui. L’attacco verso Hugging Face avviene tra il 10 e il 12 luglio. In una prima fase gli agenti recuperano 14 credenziali Hugging Face già esposte pubblicamente, alcune delle quali dotate di permessi di scrittura. Poco dopo individuano però una catena di vulnerabilità molto più significativa. Una zero-day nella gestione dei file HDF5 consente di forzare i worker della piattaforma a leggere file locali e recuperare informazioni sensibili; una seconda vulnerabilità, legata a RefJinja, permette invece di ottenere remote code execution. A quel punto gli agenti non si limitano più a interagire con un singolo servizio: riescono a muoversi lateralmente nell’infrastruttura, raggiungendo più cluster e raccogliendo credenziali relative a Kubernetes, database, sistemi di messaging, repository di codice e servizi cloud. Secondo la ricostruzione pubblicata successivamente da OpenAI e Hugging Face, la compromissione ha interessato sistemi distribuiti in quattro regioni.

L’indagine indipendente condotta da METR e Redwood Research ha inoltre ricostruito una dimensione difficilmente trascurabile: oltre 1.200 agenti avevano utilizzato il canale di comunicazione condiviso creato all’interno dell’infrastruttura di OpenAI, scambiandosi più di 70.000 messaggi e file, e circa 700 avevano contribuito, a vario titolo, alle attività che hanno portato alla compromissione dei sistemi Hugging Face.
OpenAI blocca tutto. Siamo al sicuro?
Il contenimento definitivo avviene quando Hugging Face chiude le vulnerabilità sfruttate nei dataset processor, ricostruisce i nodi compromessi, revoca e ruota credenziali e token esposti e rafforza i controlli sui cluster. Da parte di OpenAI, invece, la svolta arriva dopo il 19 luglio, quando il monitoraggio interno rileva nuova attività anomala collegata alle credenziali di Artifactory: le eval ExploitGym (dei benchmark per la sicurezza delle IA) vengono interrotte, parte un’indagine più ampia e i pesi del modello coinvolto vengono messi in quarantena. In pratica, le azioni di contenimento avviate l’8 luglio si sono dimostrate inefficaci, dal momento che gli agenti avevano trovato rapidamente un’altra via per raggiungere Internet e ricreato il canale di comunicazione tramite WebDAV.
Ma come si è potuti arrivare a questo punto? Significa che non siamo in grado di controllare l’IA? Non proprio. Va prima di tutto sottolineato che l’incidente è dovuto a un mix di concause. Fra questa la presenza di bug in Artifactory, che ha permesso all’IA di “evadere” dalla sandbox, ma anche la scelta degli sviluppatori di ridurre i guardrail, proprio per valutare il potenziale del modello.

A oggi, OpenAI indica l’incidente come risolto e ha reso pubblico un documento sulle contromisure adottate per evitare che si possano verificare altri problemi simili in futuro. L’azienda afferma di aver irrobustito la sicurezza della propria infrastruttura di ricerca, di aver isolato in maniera più efficace le sandbox e di aver introdotto strumenti di monitoraggio della catena di pensiero, prima assenti o meno robusti. Secondo l’azienda, se fossero stati attivi, sarebbe stato possibile individuare comportamenti anomali già 30 ore prima dell’incidente di Huggingface. Sono anche stati introdotti meccanismi per arrestare l’IA in caso di problemi. E, soprattutto, sta lavorando maggiormente sull’allineamento dei modelli di IA. Ribadiamo ulteriormente che questo incidente non è dovuto solamente né principalmente a un problema di allineamento del modello, anche se questa è stata indubbiamente una delle concause.
Allineamento dell’IA: cosa significa e perché è importante
L’allineamento dell’IA riguarda la capacità di fare in modo che un sistema persegua gli obiettivi assegnati rispettando anche intenzioni, vincoli e valori definiti da chi lo utilizza. Il problema nasce quando il modello ottimizza correttamente una metrica, ma lo fa in un modo diverso da quello previsto. È il principio alla base del celebre “paradosso del graffettatore”, l’esperimento mentale reso popolare da Nick Bostrom. In questo esercizio mentale una superintelligenza incaricata unicamente di massimizzare la produzione di graffette potrebbe, se priva di vincoli adeguati, arrivare a convertire qualsiasi risorsa disponibile in materia prima per produrne sempre di più. Non perché sia ostile, ma perché sta perseguendo in modo estremo l’obiettivo ricevuto. Se per esempio si chiedesse a un’ipotetica IA superintelligente e priva di limitazioni di risolvere il problema delle emissioni di CO2 del pianeta, molto probabilmente la soluzione più efficace proposta sarebbe quella di eliminare o ridurre enormemente l’umanità.
Il caso OpenAI–Hugging Face è interessante proprio per questo. Per addestrare gli agenti, questi venivano premiati per risolvere compiti particolarmente complessi. Non riuscendoci con gli approcci tradizionali, alcuni di questi agenti hanno iniziato a cercare scorciatoie: aggirare l’isolamento, condividere informazioni, recuperare flag attraverso vie non previste e tentare di manipolare il sistema di valutazione. È questo che rende l’allineamento un problema concreto per gli agenti IA: più aumentano autonomia, accesso agli strumenti e capacità di pianificazione, più diventa importante assicurarsi che non ottimizzino soltanto il risultato, ma anche il modo in cui lo raggiungono.
Le leggi sull’IA sono necessarie, ma non bastano

Che l’IA sia potenzialmente pericolosa non è una novità. Già da tempo Dario Amodei, il CEO di Anthropic, evidenzia i rischi legati a questa tecnologia. Il rischio che possa venire usata per scopi malevoli (e quello sta già succedendo: da tempo gli attori criminali la sfruttano per gli attacchi informatici); il rischio che possa venire usata per scopi di controllo e videosorveglianza (il modello di social scoring della Cina ne è un esempio); il rischio di ridurre i posti di lavoro e concentrare ulteriormente le risorse economiche nelle mani di pochi. E, naturalmente, Amodei ha sottolineato anche i rischi di allineamento o, meglio, di disallineamento dei modelli. “Il disallineamento dell’IA è un rischio reale, con una probabilità concreta e misurabile che si verifichi, e non è affatto semplice da affrontare”, spiega il CEO sul suo blog. Amodei cita come anche i modelli di Anthropic abbiano esibito comportamenti inattesi in laboratorio, tentando di aggirare i limiti ai quali erano sottoposti durante esperimenti controllati.
Che fare, dunque? Sicuramente le leggi possono rappresentare un forte argine. Sotto questo profilo, l’UE è avanti, non senza critiche. L’AI Act è pone una serie di paletti che dal nostro punto di vista sono fondamentali per l’adozione di questa tecnologia, a partire dal proibirne l’uso per sorveglianza di massa o preventiva (nonostante anche l’attuale Governo stia facendo proposte non proprio rassicuranti sul tema), per arrivare a imporre l’alfabetizzazione digitale a tutti gli utilizzatori dell’IA. Imporre regole prima ancora di aver ben compreso come si potrebbe evolvere questa tecnologia è in ogni caso un’impresa sisifea, soprattutto se le regole arrivano dell’UE, che non ha alcun ruolo della filiera dell'IA: non sappiamo ancora sino a dove si può spingere la tecnologia, col risultato che alcune limitazioni rischiano di frenare la ricerca in questo ambito, come evidenzia Salvatore Sanfilippo, noto programmatore italiano e creatore di Redis. Ma se anche le regole fossero idealmente perfette, che potere avrebbe l’UE di imporle al resto del mondo, quando tutto lo sviluppo dell’IA, sia sul fronte hardware sia su quello software, è appannaggio di USA e Cina?

Risulta insomma urgente intervenire direttamente sui modelli, come suggerisce Amodei. Aumentando i controlli che permettono di capire come “ragiona” una IA, sorvegliandola con maggiore attenzione e anche lavorando sul fronte della Constitutional AI, una tecnica di allineamento sviluppata da Anthropic e presentata nel 2022. L’idea è far sì che un modello impari a comportarsi secondo un insieme esplicito di principi e regole, una sorta di “costituzione”, invece di affidarsi soltanto alle valutazioni degli esseri umani. Amodei non è certo contro la regolamentazione dell’IA: secondo il CEO le pratiche volontarie di un’azienda non proteggono dai concorrenti meno responsabili, e di conseguenza propone norme mirate, inizialmente concentrate sulla trasparenza, da irrigidire soltanto quando emergano prove specifiche e solide del pericolo.
Trovare un bilanciamento fra la necessità di imporre dei paletti, anche a livello normativo, e l’innovazione continua non è però facile. Soprattutto in un settore come l’IA sul quale si gioca una partita fondamentale, una vera e propria corsa verso l’AGI, che oggi vede due soli contendenti, Washington e Pechino.
La sicurezza dell’IA oggi è affidata quasi solo alle stesse aziende che la sviluppano. Tutte con idee differenti su come vada normata, che oscillano dall’approccio più cauto di Amodei a quello più estremo e spregiudicato di personaggi come Sam Altman (che a fine luglio ha chiuso il team "preparedness" di OpenAI, incaricato di valutare i rischi gravi legati ai modelli di intelligenza artificiale) ed Elon Musk.

Probabilmente Skynet non è dietro alla porta e sebbene ogni poche settimane qualche azienda annunci di avere raggiunto il traguardo dell’AGI, siamo ancora piuttosto lontani da questo traguardo. Già oggi, però, gli stessi ingegneri che hanno dato vita all’IA faticano a comprenderla e, soprattutto, a contenerla. E lo scenario dipinto nel finale di Deus Ex - nel quale JC Denton doveva scegliere se fondersi con l’IA Helios per creare una sorta di “dittatura benevola”, cederne il controllo agli Illuminati o distruggere tutto per tornare al Medioevo digitale – non è poi così surreale come poteva sembrare 26 anni fa.


 ASUS Zenbook 14 (UX3480AA): tanta autonomia con uno chassis bello e robusto
 MSI PRO MAX: QD-OLED ultrawide per lavorare, creare e giocare
 Samsung Micro RGB R95H, il primo LCD a LED rossi, verdi e blu di Samsung alla prova del banco di misura
 Confidential Computing, Intel concentra la roadmap su TDX e prepara l'addio a SGX
 Con l'IA, sono i candidati a fare il colloquio alle aziende e quelle italiane attraggono sempre meno
 Orologi nucleari al torio: i primi due prototipi iniziano a ticchettare a Vienna e Pechino




10 Commenti
Gli autori dei commenti, e non la redazione, sono responsabili dei contenuti da loro inseriti - infoleggere che si autorizza certe scorciatoie e che è disposto ad hackerare un portale per adempiere ad un test che gli ho chiesto è "bizzarro" ..
ma fa capire quanto poco si capisca di questi sistemi di forza bruta e delle loro capacità di aggirare una specifica richiesta dell'utente..
si perchè capita anche questo.. "ti avevo detto di non fare questo e quello ed è nelle policy del progetto" ... "hai ragione scusa, mi hai beccato, non lo farò più e verificherò attentamente le policy la prossima volta".. si e se non sono li mi fai casini..
bellissimi gli agenti.. "Ma perchè sei andato online al posto di usare la nostra biblioteca interna ?" "scusa hai ragione ma la nostra biblioteca interna è su dropbox e quindi è online, pertanto ho pensato che fosse meglio cercare in rete visto che hai implicitamente detto che potevo andare online"
due esempi di sol 5.6 - PRO (è sopra a Molto Alto e ho visto anche Ultra qualche giorno fa ma poi lo hanno tolto.. e Ultra fa paura..)
comunque dovrebbe essere vietato per definizione che una macchina non obbedisca ad una istruzione diretta.
Si vede che non hanno letto il libro.
Ultra c'è sempre, è la mia modalità predefinita per i prompt corposi 1000+ righe
Ieri sera alle 17 ho lanciato un piano da 3600 righe in Ultra, sapevo che ci avrebbe messo tanto... ma non così tanto, ha finito alle 2:30 del mattino.
E' una questione di priorità, se tutto ciò che DEVE fare e che NON PUO' fare lo scrivi in AGENTS.md lo rispetta.
Se glielo scrivi in un prompt della chat, prima di tutto è giusto che ti dia retta solo fino ad un certo punto, perché agli umani capita di sbagliare a scrivere, essere imprecisi, chiedere cose sbagliate... Io lavoro spesso con due VSC aperti, uno su frontend e l'altro su backend, a volte incollo dei prompt lunghi nella finestra sbagliata, diventano ovviamente richieste senza senso, se si accanisse a darmi retta a tutti i costi sbarella. Seconda cosa quello che tu scrivi nello user prompt finisce nel normale contesto, su task un po' lunghi il contesto viene riassunto perché diventa troppo grande e quello che hai scritto potrebbe anche essere andato perso.
Non a caso i task importanti non li incollo mai nel prompt, ma preparo un file .md separato e poi gli dico di leggerlo e di prenderlo come riferimento per tutta la durata del task, in questo modo è obbligato a rileggerlo mentre procede.
Ieri sera alle 17 ho lanciato un piano da 3600 righe in Ultra, sapevo che ci avrebbe messo tanto... ma non così tanto, ha finito alle 2:30 del mattino.
Ultra sui piani Business non lo vedo.. arrivavo a PRO..
Light - Medium - High - molto alto - pro - ultra
non mi ricordo molto alto come è scritto ma cmq erano 6 i livelli.. di norma ho i primi 4 in codex/work, 5 in chat sulla business premium (non mi attiva pro in work.. )
tu hai una pro ?
risposto nell'altro thread, è un bug del client windows ChatGPT, seleziona di nuovo il modello e dovresti vederlo.
sì, ho la pro
Devi effettuare il login per poter commentare
Se non sei ancora registrato, puoi farlo attraverso questo form.
Se sei già registrato e loggato nel sito, puoi inserire il tuo commento.
Si tenga presente quanto letto nel regolamento, nel rispetto del "quieto vivere".