

WindTreCloud Security
Cybersecurity proattiva: viaggio nel SOC di RAD, costruito sulle competenze
di Redazione pubblicata il 30 Settembre 2026, alle 10:11 nel canale Security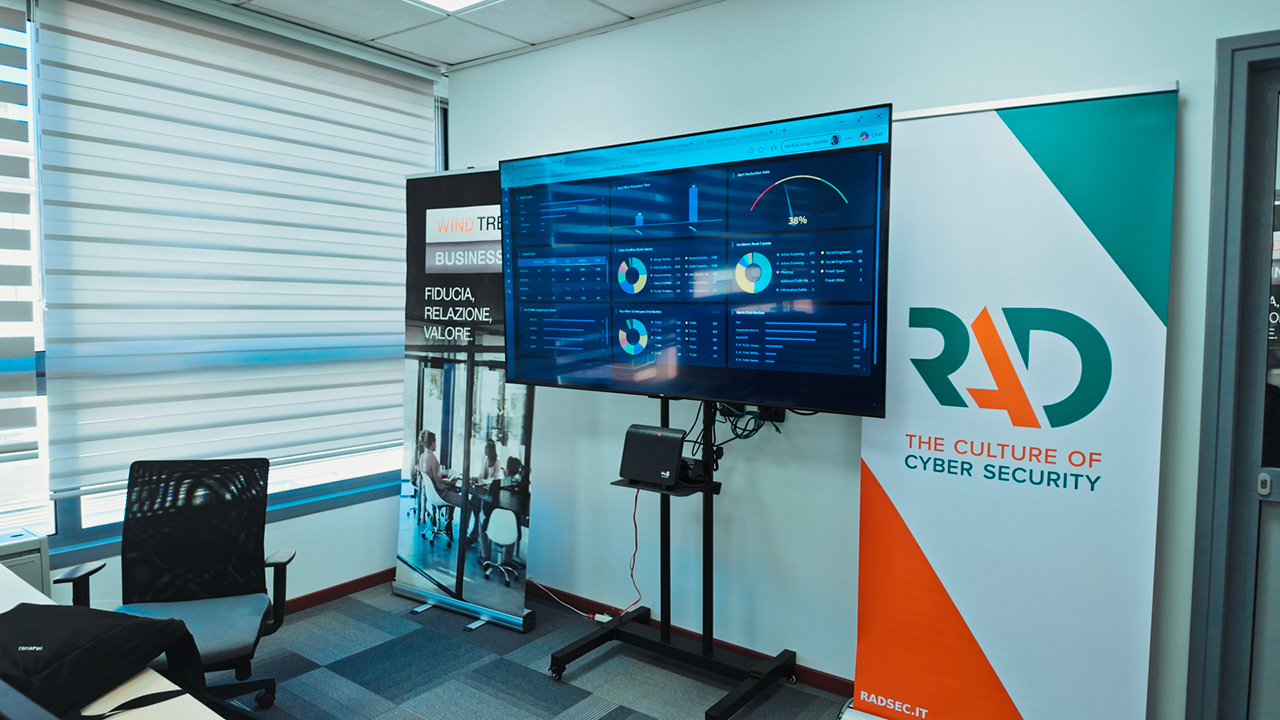
Nella sede milanese di RAD, società di cybersecurity del gruppo Wind Tre, il Security Operations Center è organizzato intorno alle competenze degli analisti, non sui tradizionali livelli. Dentro il lavoro quotidiano, tra alert, incidenti e intelligenza artificiale
Quando si parla di cybersecurity il rischio è di perdersi in una selva di sigle, e una delle più ricorrenti negli ultimi anni è quella del SOC, il Security Operations Center. Dietro l’acronimo, però, non esiste una definizione universale, e soprattutto resta poco visibile cosa accada davvero al suo interno. Per capirlo siamo andati nella sede milanese di RAD, la società del gruppo Wind Tre specializzata in cybersecurity, i cui servizi WINDTRE BUSINESS porta alle aziende, e ne abbiamo parlato con Marco Sannino, Head of Cyber Defense & Operation, e con Cristian Bruno, SOC Analyst.
Un SOC organizzato sulle competenze
Il punto di partenza è la definizione, che Sannino preferisce declinare come visione più che come formula: un SOC è la struttura che monitora "in modo reattivo e proattivo quello che accade sulle reti dei nostri clienti". La particolarità di RAD sta in come questa struttura è organizzata. Nei centri tradizionali gli analisti sono suddivisi in livelli, dal primo al terzo, con competenze diverse e incidenti che vengono gestiti o scalati a seconda della gravità. Qui quello schema non c’è.
"Noi siamo quello che viene definito uno skill based SOC", spiega Sannino. Gli analisti non sono divisi per livelli ma per aree di competenza, e ciascuno è in grado di prendere in carico qualsiasi allarme a prescindere dalla gravità e dalla natura. "Non sono più o meno competenti, sono competenti di aspetti diversi della cyber security". Attorno agli analisti lavorano poi team dedicati ad altre funzioni del centro, dai detection engineer e automation engineer impegnati nel miglioramento continuo, agli operatori di cyber threat intelligence, fino a un gruppo di ricerca che riproduce in laboratorio le tecniche di attacco per modellare il comportamento degli attaccanti. Il vantaggio di questa impostazione, sottolinea Sannino, si misura in tempi di reazione e nell’operatività quotidiana del personale.
Dal badge al triage: la giornata dell’analista
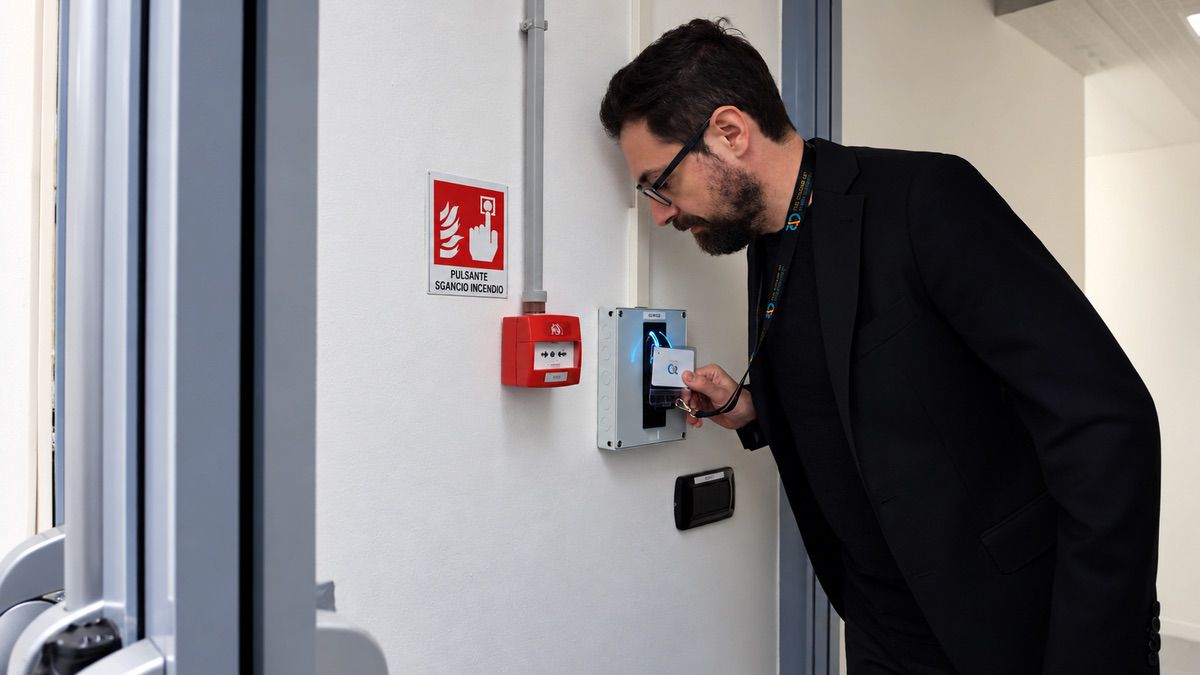
A raccontare cosa accade dietro quella parete è Cristian Bruno, che parte dall’ingresso. Ogni mattina l’accesso al centro passa da un controllo di sicurezza su documenti e badge, perché la protezione riguarda anche il luogo di lavoro. Una volta in postazione, il primo momento è il passaggio di consegne con l’analista che smonta il turno, per allinearsi sugli allarmi in corso su un determinato cliente. Il confronto avviene di persona ma anche attraverso la casella condivisa del servizio MDR, dove si controllano i thread aperti, le chiamate effettuate ai clienti e gli alert ancora da gestire.
Da lì comincia il lavoro sul flusso continuo di segnalazioni. La piattaforma genera alert, potenziali incidenti che vengono lavorati in più fasi. La prima, e per Bruno la più importante, è il triage. "Si cerca di capire in breve tempo se effettivamente quell’alert è un incidente oppure un falso positivo", spiega. Un falso positivo è un evento che ha tutte le caratteristiche dell’incidente ma non lo è, come un’attività automatizzata o l’intervento di un amministratore di sistema. Distinguere in fretta il rumore dal segnale è ciò che tiene efficiente tutto il resto della catena.
Il dialogo costante con il cliente
Il lavoro dell'analista non si esaurisce all'interno del SOC: l'obiettivo finale è proteggere il business del cliente. Ogni evento rilevante viene notificato secondo un livello di priorità definito in base alla gravità dell'incidente e agli SLA concordati, utilizzando i canali previsti dal servizio.
Il cliente può confermare o smentire l'attività rilevata, ma è proprio l'assenza di conferma a rappresentare un importante campanello d'allarme. "Nel caso della non conferma si sale esponenzialmente di gravità", spiega Bruno, perché aumenta la probabilità di trovarsi di fronte a un comportamento anomalo o malevolo.
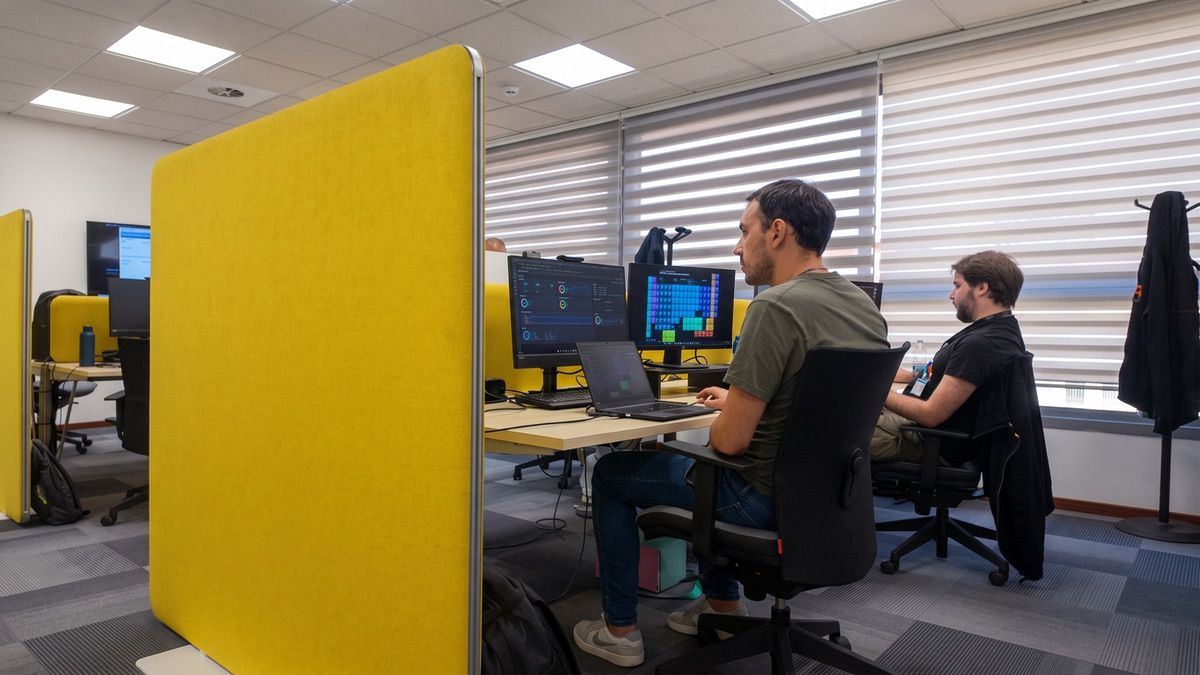
È in questo momento che il servizio MDR mostra il proprio valore distintivo. Il team non si limita a segnalare l'evento, ma può intervenire direttamente sugli asset protetti. In base ai playbook condivisi con il cliente, vengono avviate azioni di contenimento come l'isolamento di un endpoint compromesso o la sospensione di un'utenza sospetta, anche mentre le attività di analisi sono ancora in corso.
Parallelamente, l'indagine si approfondisce: gli analisti raccolgono ulteriori elementi di contesto confrontandosi direttamente con il cliente e, quando necessario, coinvolgono il team di Incident Response. L'obiettivo è uno solo: circoscrivere la minaccia e ripristinare la normale operatività nel minor tempo possibile, riducendo al minimo l'impatto sul business.
"È la gravità dell'incidente a determinare le modalità di intervento", aggiunge Sannino. Per gli eventi a bassa severità può essere sufficiente una comunicazione via email, mentre nei casi più critici viene attivata un'escalation telefonica: "È qualcosa che facciamo per dare immediata evidenza al cliente che sta accadendo qualcosa di rilevante".
Al vertice della scala si trovano le situazioni di crisi vere e proprie, caratterizzate da impatti operativi significativi o dalla compromissione di dati sensibili, anche sotto il profilo normativo. In questi casi entrano in azione gli specialisti di Incident Response, chiamati a gestire l'emergenza e a supportare il cliente fino al completo ripristino delle attività.
In altre parole, il valore di un servizio MDR non si misura soltanto nella capacità di individuare una minaccia, ma soprattutto nella rapidità con cui riesce a contenerla e neutralizzarla, trasformando la cybersecurity da funzione reattiva a strumento concreto di continuità operativa e resilienza aziendale.
Quando scatta l’incidente: un caso reale
Nella gestione di un incidente grave si forma un team eterogeneo, in cui agli incident responder si affiancano detection engineer, automation engineer, analisti del SOC e operatori di cyber threat intelligence. Sannino porta un esempio concreto. Il team di intelligence aveva rilevato la compromissione di un fornitore di un cliente e, poiché la partnership con quel cliente era pubblica, RAD si è attivata per verificare se il fornitore avesse accessi all’infrastruttura tecnologica dell’azienda protetta.
Alla conferma è partita la reazione coordinata: gli analisti hanno passato al setaccio gli allarmi recenti alla ricerca di indicatori legati al fornitore, il team di incident response ha avviato un’attività di threat hunting proattivo per intercettare eventuali segnali deboli, e i detection engineer hanno creato regole di rilevamento specifiche sugli accessi e i comportamenti delle utenze di quel fornitore. La vicenda non si è tradotta in un incidente grave, ed è proprio questo il punto: anticipare invece di rincorrere. "Per noi questo è vedere i vari team collaborare verso l’obiettivo, proteggere i nostri clienti", riassume Sannino.
Gli strumenti e il ruolo dell’intelligenza artificiale
Dietro il lavoro quotidiano ci sono naturalmente le tecnologie. Bruno indica come strumenti principali il SIEM, il collettore che raccoglie e analizza i log dei clienti e da cui nascono gli alert destinati al SOAR, e l’EDR, che presidia gli endpoint dei clienti analizzandone di continuo il comportamento per far emergere le attività anomale.

Su questa base si innesta l’intelligenza artificiale, che per Sannino va distinta a seconda degli scenari. Il machine learning è ormai parte intrinseca delle tecnologie e degli use case di monitoraggio da diversi anni. Con l’arrivo degli LLM è comparso un assistente virtuale che arricchisce le informazioni a disposizione dell’analista, già integrato nel servizio MDR nel rispetto dei principi di sovranità e residenza dei dati. Negli ultimi 12 mesi il fronte si è spostato sugli agenti, con le sperimentazioni su agentic SOC e autonomous SOC condotte sia con le tecnologie in uso sia con il dipartimento di ricerca e sviluppo.
Resta però fermo un principio: "Crediamo fortemente nel concetto di human in the loop", dice Sannino, con l’essere umano che continua a dare il valore aggiunto alle tecnologie. E qui il cerchio si chiude con l’organizzazione del centro, perché è proprio il modello senza livelli a rendere più semplice e rapida l’adozione di queste nuove forme di intelligenza artificiale all’interno del SOC.


 ASUS Zenbook 14 (UX3480AA): tanta autonomia con uno chassis bello e robusto
 MSI PRO MAX: QD-OLED ultrawide per lavorare, creare e giocare
 Samsung Micro RGB R95H, il primo LCD a LED rossi, verdi e blu di Samsung alla prova del banco di misura
 Confidential Computing, Intel concentra la roadmap su TDX e prepara l'addio a SGX
 Con l'IA, sono i candidati a fare il colloquio alle aziende e quelle italiane attraggono sempre meno
 Orologi nucleari al torio: i primi due prototipi iniziano a ticchettare a Vienna e Pechino